
Nuôi con tốn hơn đẻ con — vì sao AI Inference đang soán ngôi AI Training
Từng có thời cả làng công nghệ chỉ chăm chăm đếm số GPU train model. Nhưng khi reasoning model bắt đầu "nghĩ" trước khi nói và agent chạy loop thâu đêm, hóa đơn inference mới là thứ khiến các CFO toát mồ hôi hột.
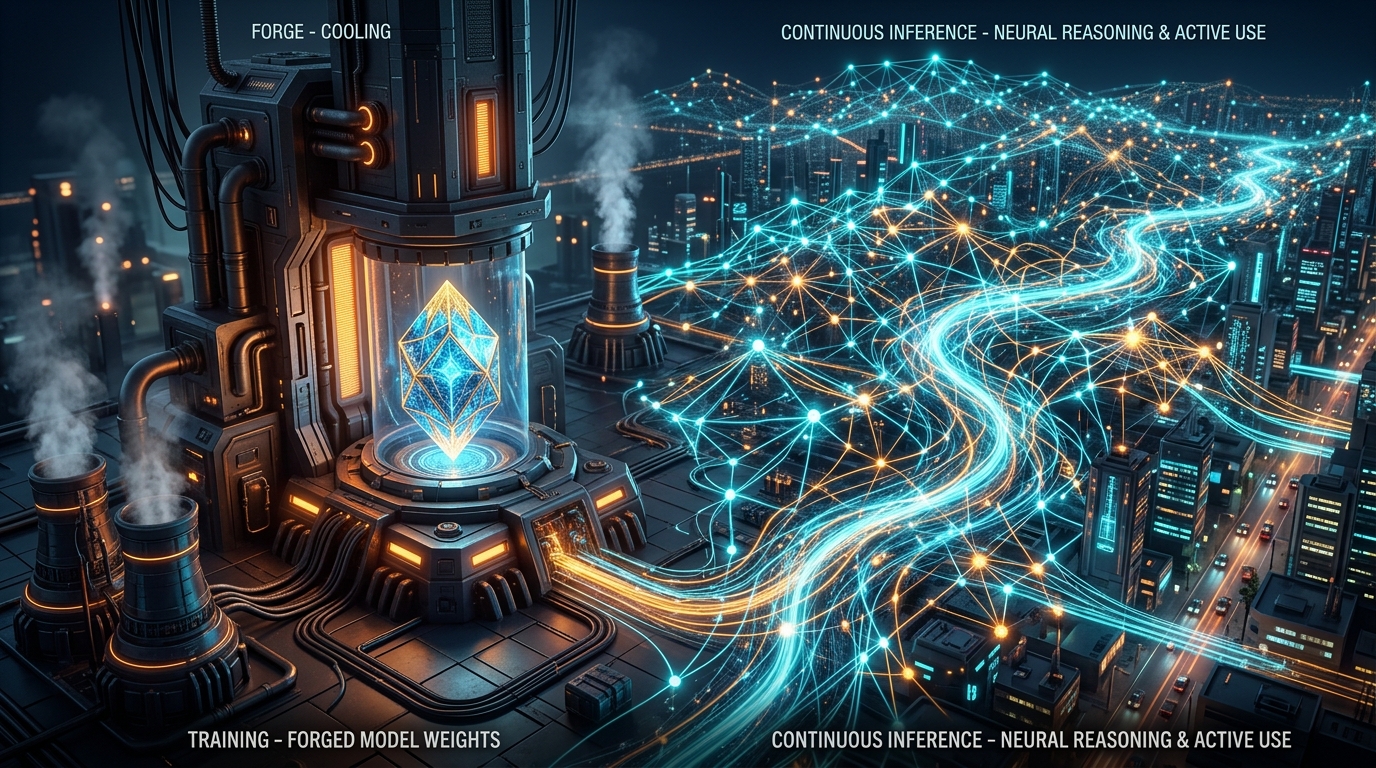
Mấy năm trước, mỗi lần mở mạng ra là lại thấy một công ty khoe: “Chúng tôi vừa gom được mười nghìn con H100 để luyện mô hình mới”. Cảm giác như thời các lò luyện đan kiếm hiệp: bế quan luyện công ba năm ròng rã, đốt vài chục triệu đô tiền điện, rồi một ngày đẹp trời bước xuống núi xưng bá võ lâm.
Nhưng dạo gần đây, bạn có để ý thấy các đại ca bỗng dưng bớt khoe số GPU dùng để train không?
Thay vào đó, người ta bắt đầu thầm thì về những chuyện kém hào nhoáng hơn nhiều: bộ nhớ đệm KV cache, tỉ lệ hit rate của prefix cache, trần latency khi stream token, và cái hóa đơn API cuối tháng tăng vọt theo hình cây tre.
Nói một cách dân dã kiểu anh em ngồi quán trà đá: đẻ con thì đau một lần, nhưng nuôi con ăn học hai mươi năm mới là thứ làm rỗng ví cha mẹ.
Trong thế giới AI lúc này, Training chính là lúc sinh nở, còn Inference — việc chạy mô hình cho hàng triệu người dùng mỗi giây — chính là chuỗi ngày nuôi nấng tốn kém không hồi kết. Và cán cân giữa hai phe đã chính thức đảo chiều.
Từ con số 80/20 bị lật ngược
Để không biến bài viết thành buổi chém gió vô căn cứ, chúng ta nhìn thẳng vào số liệu của các hãng theo dõi bán dẫn và hạ tầng đám mây.
Quay lại năm 2023, tỷ trọng chi tiêu GPU và điện toán đám mây cho AI rất rõ ràng: khoảng 70–80% năng lực điện toán dồn cho Training, phần còn lại còm cõi dành cho Inference. Hồi đó, mô hình lớn còn ít người dùng thật, ứng dụng chủ yếu dừng ở mức demo gõ vài câu thơ hoặc tóm tắt đoạn văn ngắn.
Đến giữa năm 2026, các báo cáo từ Morgan Stanley, SemiAnalysis và cả tuyên bố của Jensen Huang (CEO Nvidia) cho thấy bức tranh hoàn toàn trái ngược:
| Hạng mục | Thời kỳ 2022–2023 | Hiện tại (2025–2026) |
|---|---|---|
| Trọng tâm Capex | Gom cụm cluster huấn luyện khổng lồ | Cụm máy chủ phục vụ suy luận mật độ cao |
| Tỉ trọng Compute toàn cầu | Training chiếm ~75% | Inference chiếm hơn 70–80% |
| Nút thắt kỹ thuật lớn nhất | Băng thông liên kết cụm (InfiniBand/NVLink) | Băng thông bộ nhớ (HBM) & dung lượng VRAM |
| Mô hình kinh tế | Chi một lần (One-off Capex) | Chi phí vận hành tỉ lệ thuận theo traffic (Linear Opex) |
Tại sao lại có cú “quay xe” ngoạn mục này? Có ba nguyên nhân gốc rễ đang diễn ra đồng thời.
1. Bức tường Pre-training: Lợi suất giảm dần
Lý do đầu tiên đến từ chính phía Training: định luật mở rộng (Scaling Laws) cổ điển đang húc đầu vào bức tường đá.
Suốt từ GPT-2 lên GPT-4, công thức thành công rất đơn giản: gom thêm text trên Internet, mua thêm GPU, train lâu hơn. Nhưng đến ngưỡng hiện tại:
- Hết dữ liệu sạch: Con người tạo ra bao nhiêu sách vở, Wikipedia, mã nguồn GitHub, báo chí tử tế thì các hãng đã cào sạch sành sanh và nhét vào máy nghiền hết rồi. Dữ liệu mới tạo ra toàn là… AI tự sinh, mà lấy rác AI đi train lại AI thì mô hình sẽ bị “thoái hóa” (model collapse).
- Hiệu năng biên tụt dốc: Để giảm loss hoặc tăng vài điểm phần trăm trên các bảng xếp hạng học thuật, chi phí huấn luyện tăng từ 10 triệu đô lên 100 triệu đô, rồi ngấp nghé 1 tỉ đô. Bỏ ra thêm 900 triệu đô chỉ để con bot giải toán chuẩn hơn một tí là một bài toán kinh tế không ai gánh nổi mãi.
Các phòng lab nhận ra: tiếp tục đốt tiền cố nhét thêm tham số vào mô hình tĩnh lúc train là hạ sách. Muốn nó thông minh hơn trong thực tế, phải chuyển trọng tâm sang lúc nó vận hành.
2. Kỷ nguyên “Test-Time Compute” — Khi AI biết nghĩ trước khi nói
Đây là cú đấm quyết định khiến Inference nuốt chửng tài nguyên.
Trước đây, khi bạn gửi một câu hỏi vào ChatGPT hay Claude đời cũ, mô hình hoạt động theo kiểu “bắn phát một” (single-pass feed-forward). Bạn ném vào 50 tokens câu hỏi, mô hình nhả ra 100 tokens câu trả lời. Độ phức tạp tính toán gần như cố định: hỏi câu dễ hay câu khó, số phép tính ma trận mô hình thực hiện trên mỗi token sinh ra đều y như nhau.
Nhưng từ khi các dòng mô hình reasoning xuất hiện — từ OpenAI o1, o3, DeepSeek R1 cho đến Claude 3.7 Sonnet với chế độ Hybrid Reasoning và Gemini Thinking — luật chơi đã đổi 180 độ.
Khái niệm này được gọi là Test-Time Compute (hoặc Inference-Time Scaling):
- Thay vì trả lời ngay, mô hình tự tạo ra một chuỗi suy nghĩ ẩn (Chain of Thought).
- Nó thử đi theo hướng A, thấy bế tắc thì quay lui (backtracking), thử hướng B.
- Nó tự viết code kiểm tra, chạy thử nghiệm, tự dò lỗi và phản biện chính mình trước khi chốt đáp án cuối cùng.
Để trả lời một bài toán hóc búa hay tái cấu trúc một module code phức tạp, người dùng có thể chỉ nhìn thấy 200 từ giải thích. Nhưng ở phía sau màn nhung, mô hình đã âm thầm cắn hết 15.000 đến 30.000 “thinking tokens”.
Cứ mỗi câu hỏi của bạn, con chip ở data center phải chạy cật lực gấp 50 đến 100 lần so với trước kia. Bạn không còn trả tiền cho việc mô hình “thuộc bài”, bạn đang trả tiền điện cho từng giây mô hình “vắt óc suy nghĩ”.
3. Cơn bão AI Agents: Vòng lặp thâu đêm không ngủ
Nếu như người dùng ngồi gõ chat chỉ hỏi vài chục câu một ngày, thì “khách hàng” lớn nhất của Inference hiện nay lại không phải con người. Đó là AI Agents.
Khi bạn giao cho một coding agent (như Claude Code, Cursor, hay Antigravity) một nhiệm vụ: “Tìm bug race-condition trong module thanh toán và viết unit test phủ hết các case”, chuyện gì sẽ xảy ra?
[Agent Loop]
1. Đọc codebase & tree thư mục   --> Ăn 80.000 input tokens
2. Lập kế hoạch & chọn file      --> Sinh 2.000 reasoning tokens
3. Gọi tool đọc file A, B, C     --> Thêm 40.000 input tokens
4. Chạy test thử nghiệm          --> Nhận 5.000 tokens lỗi terminal
5. Tự ngẫm nghĩ nguyên nhân      --> Sinh 4.000 reasoning tokens
6. Sửa file & chạy lại test      --> Lặp lại bước 3-5 thêm 4 lần nữa...
Chỉ sau 3 phút bạn ngồi nhấp ngụm trà, con agent đã nuốt trọn nửa triệu tokens.
Một lập trình viên trước kia dùng hết 50.000 tokens/ngày khi chat hỏi đáp. Nhưng khi đưa agent vào quy trình làm việc tự động hóa (CI/CD, triage issue, viết test, migrate DB), một kỹ sư có thể kích hoạt hàng chục triệu tokens mỗi ngày.
Mô hình không cần train lại một tí nào cả. Trọng số (weights) đóng băng nguyên xi. Nhưng GPU thì quay hết công suất 24/7 chỉ để phục vụ các vòng lặp reasoning đó.
Hạ tầng đảo lộn: Nút thắt không còn là sức mạnh tính toán
Sự bùng nổ của Inference đang làm thay đổi tận gốc rễ cách người ta thiết kế phần cứng và phòng máy chủ.
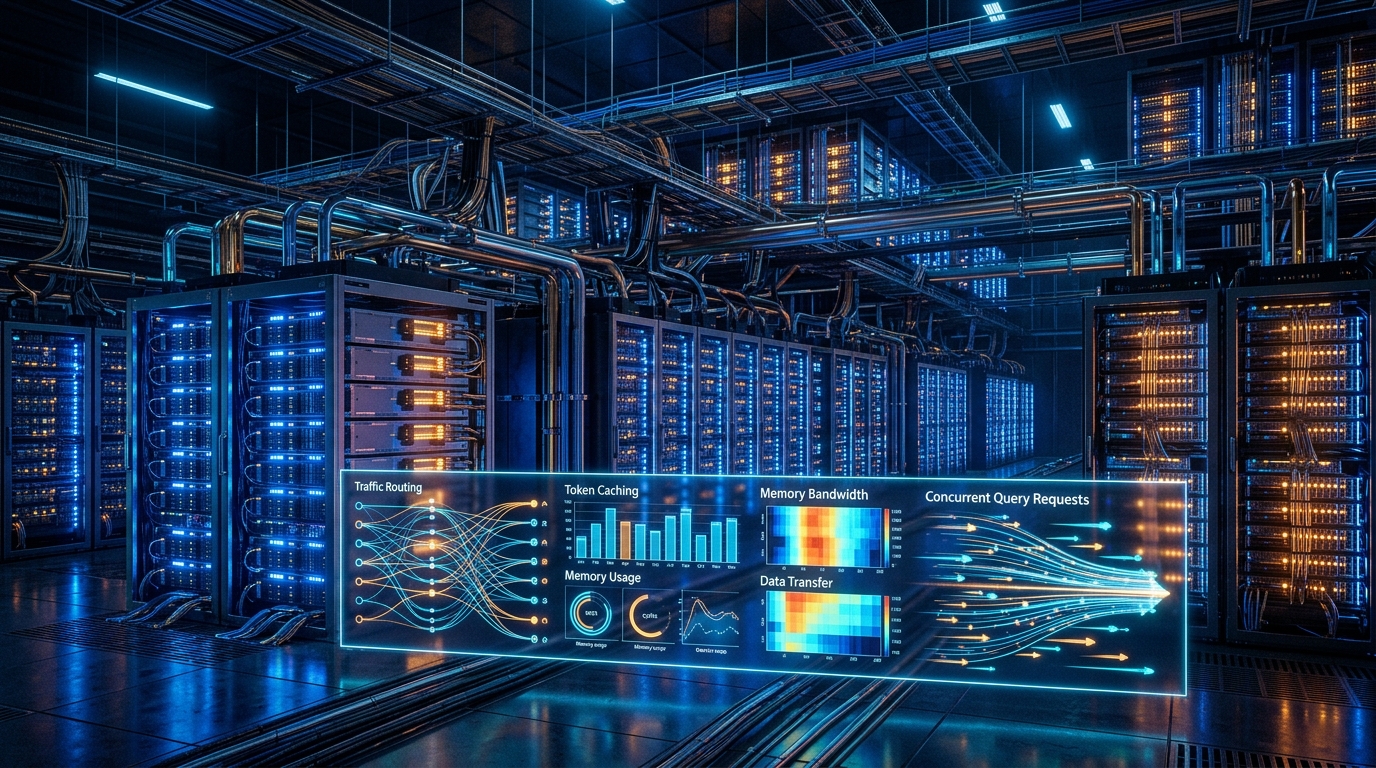
Nếu bạn làm kiến trúc hệ thống, đây là những điểm khác biệt chí mạng giữa hai thế giới:
Băng thông bộ nhớ (Memory Bandwidth) thay vì FLOPS
Khi train model, bạn xử lý các lô dữ liệu (batch) cực lớn cùng lúc, thuật toán tận dụng tối đa các nhân tính toán ma trận (Matrix Cores). Con chip luôn đói FLOPS.
Nhưng khi làm Inference phục vụ người dùng thật, nút thắt chuyển sang băng thông bộ nhớ. Cứ mỗi khi sinh ra 1 token mới, mô hình phải tải toàn bộ trọng số (weights) hàng trăm gigabyte từ VRAM vào nhân tính toán, cộng thêm việc truy xuất KV Cache (bộ nhớ lưu lại ngữ cảnh các token đã sinh trước đó). GPU xịn đến mấy mà băng thông truyền tải dữ liệu giữa chip nhớ HBM và nhân xử lý bị nghẽn thì nhân GPU vẫn phải ngồi chơi xơi nước chờ dữ liệu.
Cuộc cách mạng giảm độ chính xác (FP8 & FP4)
Để nhét vừa mô hình to vào ít GPU hơn và giảm gánh nặng băng thông, cả ngành công nghiệp đang đổ xô xuống FP8 và FP4 (dấu phẩy động 4-bit). Các dòng chip mới như Nvidia Blackwell hay các bộ tăng tốc chuyên dụng (LPU của Groq, TPU của Google) được “đo ni đóng giày” để chạy lượng tử hóa (quantization) ở tốc độ bàn thờ mà suy hao chất lượng suy luận gần như bằng không.
Nghệ thuật quản lý bộ nhớ: PagedAttention & Prefix Caching
Nếu viết backend truyền thống có cache Redis, thì backend của AI Inference có PagedAttention (được phổ biến bởi vLLM) và Prefix Caching.
- Nếu 1.000 lập trình viên cùng chia sẻ một System Prompt dài 10.000 từ, hệ thống inference thông minh sẽ không tính toán lại 10.000 từ đó 1.000 lần. Nó lưu vết KV cache của phần prompt chung trên bộ nhớ, giúp giảm 80% thời gian tạo token đầu tiên (TTFT - Time To First Token) và giảm hàng đống tiền điện.
4 bài học thực tế cho dân làm sản phẩm
Hiểu được xu hướng này thì bạn làm được gì vào thứ Hai tuần tới khi họp team?
1. Đừng vội mua GPU về tự host mô hình “khủng”
Nhiều team hay nhẩm tính: “Mua cụm 8 con H100 tốn vài tỉ, nhưng không phải trả tiền API cho OpenAI nữa, năm sau là hòa vốn.”
Tính thế là quên bài toán tải biến thiên. Khi tự host, lượng GPU bạn mua phải chịu được tải đỉnh (peak load). Nhưng vào ban đêm hay những lúc vắng khách, dàn máy vẫn cắn điện, điều hòa vẫn chạy ầm ầm, khấu hao vẫn trừ đều từng ngày. Trừ khi bạn có lượng truy cập đều đặn 24/7 ở quy mô khổng lồ, còn không, dùng API của các hyperscaler (những bên biết tận dụng pooling tài nguyên) vẫn rẻ và nhẹ đầu hơn gấp bội.
2. Thiết kế cơ chế phân tầng mô hình (Model Routing)
Đừng dùng búa tạ đập hạt đậu. Đừng bao giờ ném mọi câu hỏi của người dùng vào các mô hình reasoning đắt đỏ như o3 hay Claude 3.7 Sonnet thinking mode.
- Câu hỏi chào hỏi, trích xuất thực thể, phân loại tag: route sang mô hình nhỏ (Small Language Models như Llama 3 8B, Gemma 2, hoặc các bản Flash/Haiku) với chi phí chỉ bằng 1/50.
- Chỉ khi nào gặp bài toán đòi hỏi suy luận nhiều bước, coding phức tạp, hay phân tích logic nhiều tầng, router mới chuyển tiếp sang reasoning model.
3. Đặt trần cho “Test-Time Compute” (Budget Caps)
Hầu hết các API reasoning hiện nay đều cho phép bạn đặt tham số kiểm soát số lượng token suy nghĩ (ví dụ thinking_budget hoặc max_completion_tokens).
Nếu không thiết lập giới hạn này, một câu prompt mập mờ có thể khiến mô hình “nghĩ quẩn” trong một vòng lặp triết học không lối thoát và đốt sạch hạn mức thẻ tín dụng của bạn chỉ sau một đêm.
4. Coi Token Context như dung lượng RAM quý giá
Thời kỳ quăng cả file PDF 500 trang vào context window “cho tiện” đã qua rồi. Dù context window của các mô hình có mở rộng lên 1 triệu hay 2 triệu tokens, chi phí đọc lại (prefill cost) và dung lượng KV cache trên server sẽ khiến ứng dụng của bạn vừa chậm vừa đắt. RAG (Retrieval-Augmented Generation) tử tế kết hợp với reranking chính xác vẫn là người bạn thân thiết nhất của ví tiền công ty.
Lời kết
Thế giới AI đã chính thức bước qua giai đoạn “ở nhà cha mẹ nuôi ăn học”. Thời kỳ các lab AI đốt tiền tỷ của quỹ đầu tư chỉ để khoe điểm benchmark huấn luyện đang dần nhường chỗ cho kỷ luật tài chính tàn nhẫn của thị trường thực tế.
Bây giờ là lúc mô hình phải đi làm kiếm sống. Và trên thương trường, không ai quan tâm ngày xưa bạn mất bao nhiêu năm luyện thi; người ta chỉ quan tâm mỗi lần bạn mở miệng giải quyết một vấn đề, bạn tốn bao nhiêu năng lượng và đem lại bao nhiêu giá trị.
Lần tới khi sếp bạn thắc mắc tại sao hóa đơn dịch vụ AI tháng này tăng gấp đôi dù số lượng nhân sự không đổi, đừng vội tìm xem ai quên tắt server. Hãy kiểm tra xem team dev có vừa cài một con AI Agent tự động chạy loop xuyên màn đêm hay không nhé!
Found this insightful? Like or share with your team:
Spread good engineering craft & architecture lessons.
Comments
Email is not published. Keep it professional.