
An toàn AI và quản lý AI toàn cầu — cuộc đua mà không ai muốn về nhất một mình
Thế giới đang cố nhét một công nghệ phát triển theo hàm mũ vào một cái khung pháp lý xây theo nhịp hành chính. EU ra EU AI Act, Mỹ ra Executive Order, Trung Quốc ra quy định riêng — ai cũng vẽ sân, nhưng quả bóng thì không hỏi ý kiến ai.
Ngồi uống trà đá mà nghĩ đến câu chuyện an toàn AI, người ta dễ rơi vào một trong hai thái cực.
Thái cực một: “Ôi thôi AI nó sắp diệt loài người rồi, đọc Sam Altman nói về AGI mà rùng mình.” Thái cực hai: “Mấy ông researcher cứ lo xa, thực tế GPT-4o còn không làm nổi cái pivot table cho mình.”
Cả hai đều sai. Nhưng cái đúng lại không nằm ở giữa một cách đơn giản như vậy — nó phức tạp hơn, và vì thế mới đáng để ngồi nói chuyện.
Bài này không phải về việc AI có hại hay không hại. Bài này là về một câu hỏi thực tế hơn: khi công nghệ chạy nhanh hơn luật pháp, thế giới đang cố xử lý cái khoảng cách đó như thế nào?
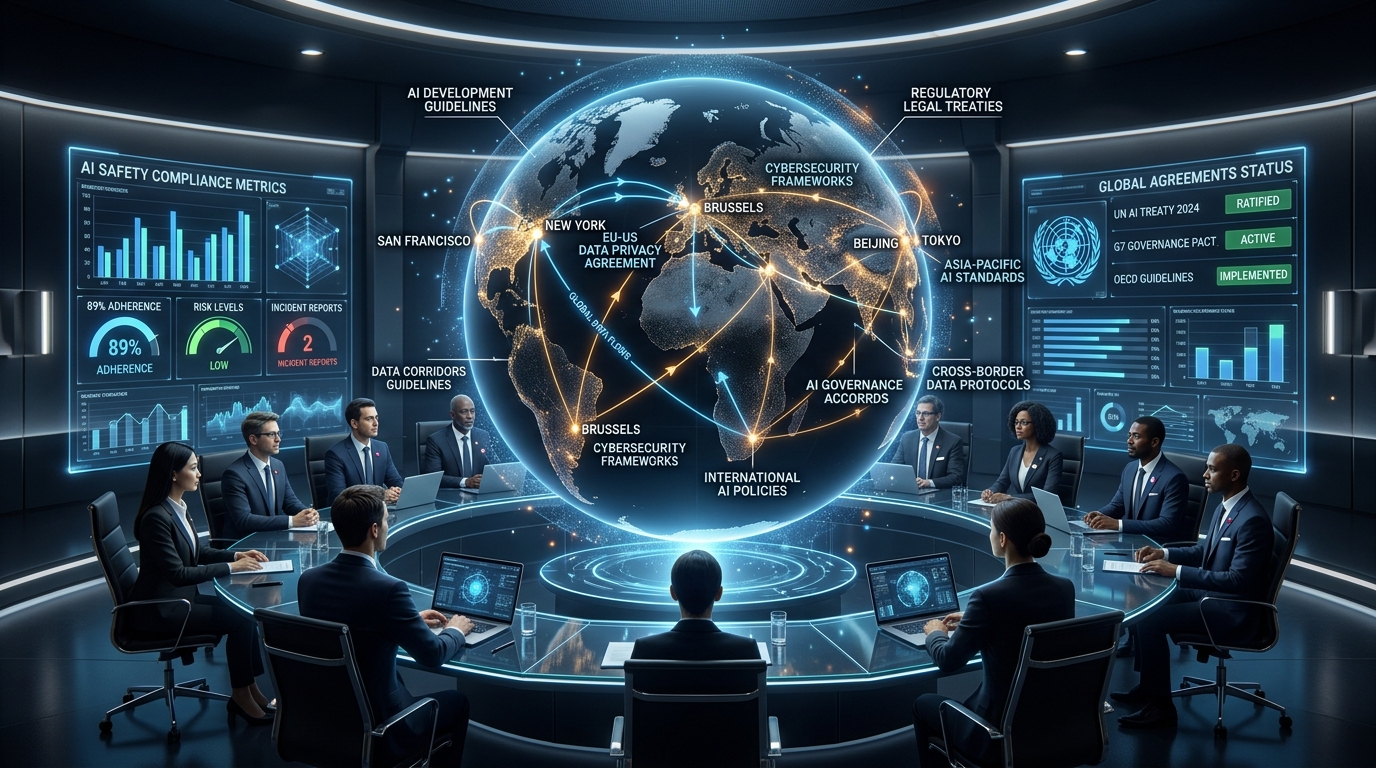
Hình 1. Quản trị AI toàn cầu: mỗi khối kinh tế vẽ khung pháp lý riêng, nhưng AI thì không dừng lại ở biên giới.
Trước hết: “an toàn AI” là gì?
Đây là nơi nhiều cuộc tranh luận đổ vỡ ngay từ đầu vì mọi người đang nói về những thứ khác nhau dưới cùng một nhãn.
AI safety trong cộng đồng nghiên cứu thường chỉ cụm vấn đề dài hạn: model alignment (làm sao để AI làm đúng cái mình muốn, không phải cái nó suy luận ra), corrigibility (làm sao để con người tắt được AI khi cần), và catastrophic risk (tránh các kịch bản AI tự ý làm gì đó ở quy mô toàn cầu).
AI safety theo nghĩa hẹp hơn, kiểu monitoring production — là thứ mà team product phải lo: hallucination rate, bias trong output, data poisoning, prompt injection, model drift theo thời gian.
AI governance thì rộng hơn: là bộ khung — luật, tiêu chuẩn, cơ chế kiểm tra — để xã hội quyết định ai được làm gì với AI và chịu trách nhiệm thế nào khi nó hỏng.
Ba cái này liên quan chặt, nhưng không giống nhau. Một model perfectly aligned về mặt kỹ thuật vẫn có thể gây hại nếu không có governance tốt. Và governance tốt trên giấy cũng bằng không nếu team kỹ thuật không có công cụ đo được model đang làm gì.
Ba ông lớn, ba bộ sách luật
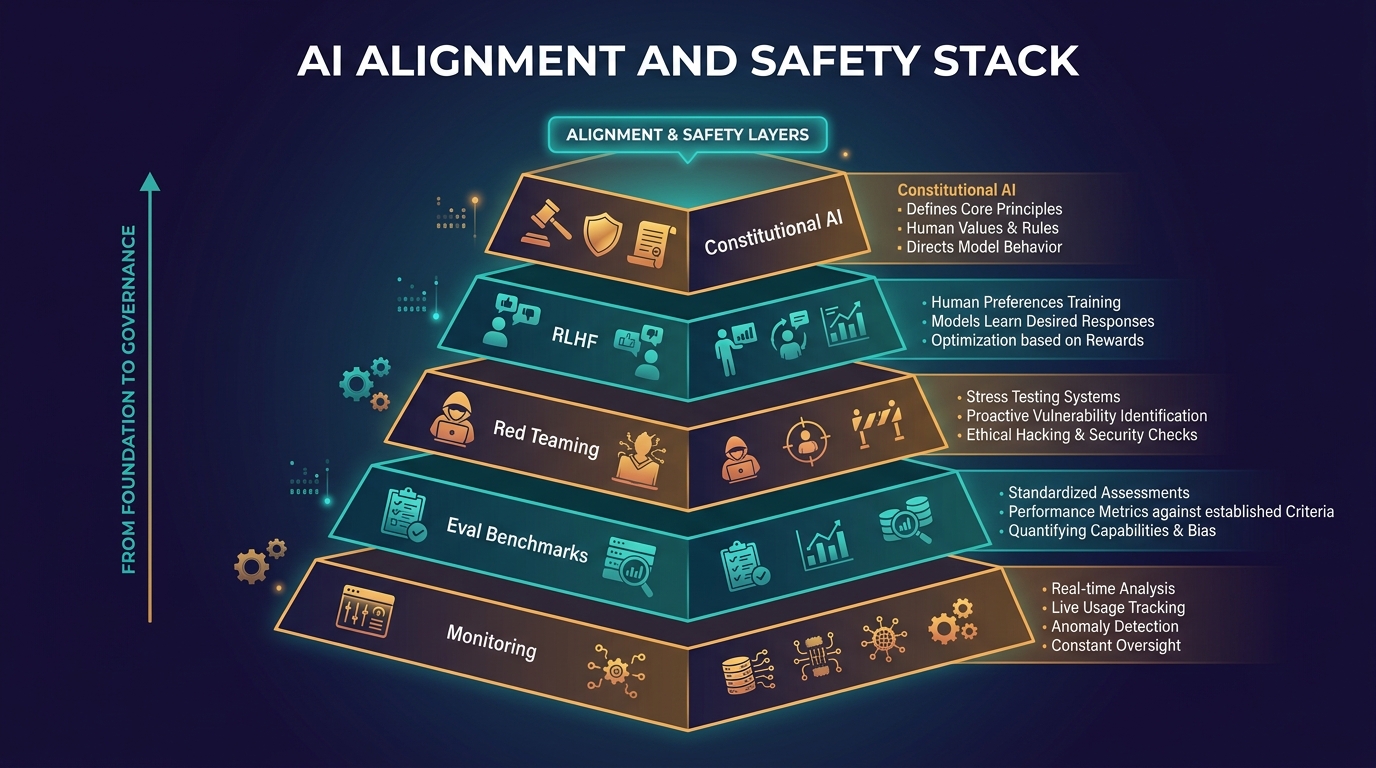
Hình 2. Safety stack kỹ thuật: mỗi tầng giải một lớp vấn đề khác nhau — không có tầng nào là viên đạn bạc duy nhất.
Câu chuyện quản lý AI toàn cầu hiện tại thực ra là câu chuyện của ba trung tâm quyền lực đang vừa cạnh tranh vừa cố phối hợp nhau.
Liên minh châu Âu — quy định trước, xin lỗi sau
EU ra EU AI Act — bộ luật toàn diện đầu tiên của thế giới về AI, có hiệu lực đầy đủ từ 2026. Cách tiếp cận của EU là phân loại rủi ro:
- Unacceptable risk (cấm hoàn toàn): social scoring của nhà nước như kiểu Trung Quốc, nhận diện cảm xúc nơi công cộng, AI khai thác lỗ hổng tâm lý của người dùng dễ bị tổn thương.
- High-risk (phải kiểm định, ghi nhật ký, có human oversight): AI trong tuyển dụng, tín dụng, giáo dục, hạ tầng quan trọng.
- General purpose AI / frontier models: phải công bố tài liệu kỹ thuật, tuân thủ tiêu chuẩn copyright, làm adversarial testing với model trên 10²⁵ FLOPs.
EU thường bị chê là quá chậm, quá phức tạp, dễ làm khó doanh nghiệp châu Âu hơn là kiểm soát được BigTech Mỹ. Không hoàn toàn sai. Nhưng EU AI Act cũng có Brussels Effect: các công ty muốn bán vào thị trường EU sẽ phải tuân thủ, kéo theo tiêu chuẩn lan ra toàn cầu kiểu GDPR.
Mỹ — thị trường trước, rồi mới nhìn lại
Mỹ đi theo hướng khác hẳn: Executive Order on AI (tháng 10/2023) đặt yêu cầu báo cáo với NIST cho các model lớn, nhưng không có luật bắt buộc kiểu EU. Mọi thứ vẫn khá voluntary — phụ thuộc vào commitment của từng công ty.
Lý do là tư tưởng kinh tế: siết quá sớm có thể làm Mỹ mất vị thế dẫn đầu AI so với Trung Quốc. Đây là argument hợp lý, nhưng cũng là argument mà ngành công nghiệp thích dùng nhất vì lý do hiển nhiên.
NIST AI RMF (Risk Management Framework) là thứ đáng chú ý nhất từ phía Mỹ: một framework thực dụng để tổ chức đánh giá, đo và giảm thiểu rủi ro AI trong nội bộ. Không phải luật, nhưng đang dần trở thành tiêu chuẩn ngầm cho contractor làm với chính phủ liên bang.
Trung Quốc — kiểm soát nội dung là ưu tiên số một
Trung Quốc không thiếu quy định AI — thực ra có khá nhiều: quy định về generative AI (2023), quy định về recommendation algorithms, quy định về deep synthesis (deepfake). Nhưng trọng tâm rất khác EU và Mỹ: ưu tiên là kiểm soát thông tin và bảo đảm “giá trị cốt lõi xã hội chủ nghĩa”, không phải bảo vệ người dùng theo nghĩa phương Tây.
Đây không phải phán xét — chỉ là ghi nhận trade-off khác nhau. Một quốc gia độc đảng và một liên minh dân chủ sẽ có mô hình rủi ro khác nhau, và sẽ quyết định an toàn nghĩa là gì theo cách khác nhau.
Vấn đề thực sự: ai nhường ai?
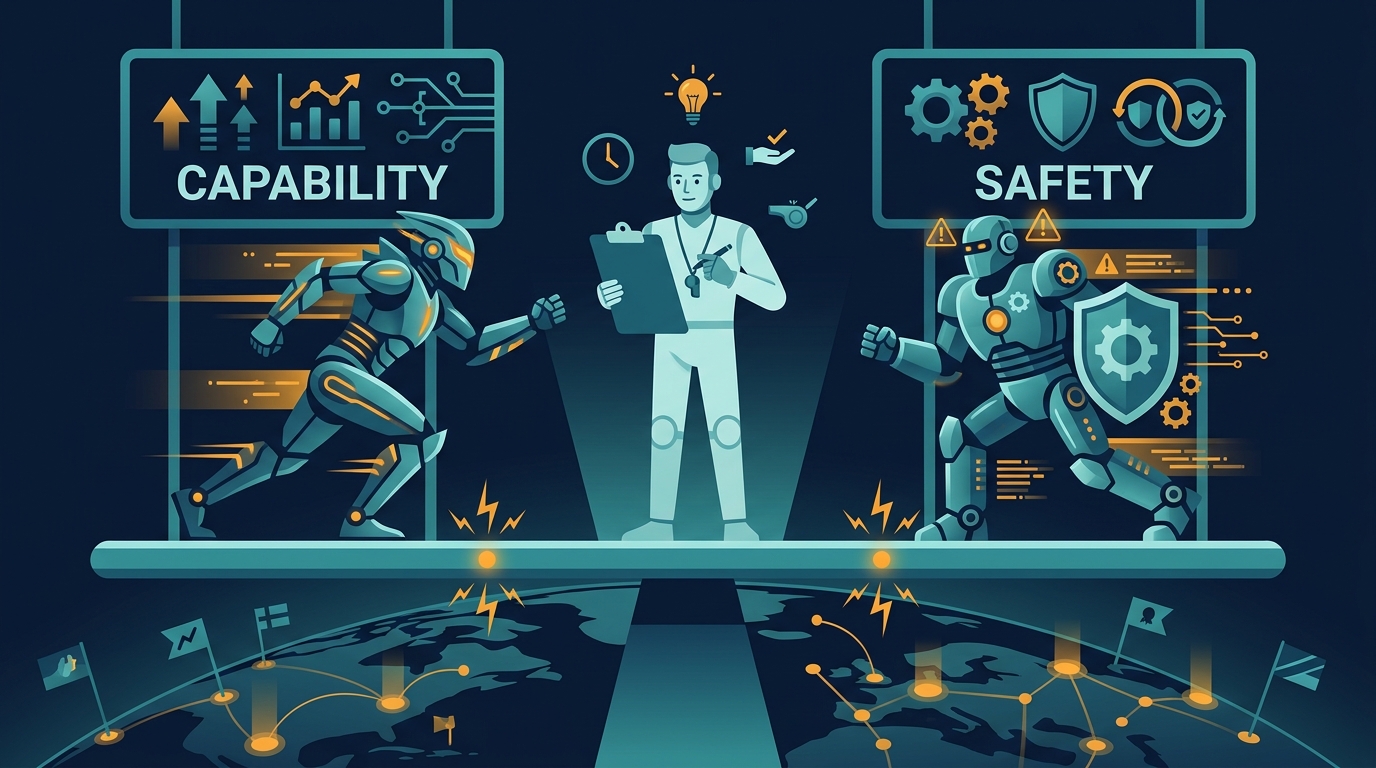
Hình 3. Cuộc cân bằng không hồi kết: capability và safety đều cần tăng, nhưng tốc độ tăng của hai bên không đồng đều.
Bài toán nan giải nhất của AI governance toàn cầu không phải là thiếu ý tưởng. Là coordination problem.
Hãy tưởng tượng game lý thuyết đơn giản: nếu Mỹ siết quy định AI, Trung Quốc không siết, Trung Quốc sẽ đi nhanh hơn. Nếu tất cả cùng không siết, cuộc đua xuống đáy về an toàn. Nếu tất cả cùng siết đủ mạnh — lý tưởng, nhưng cần tin tưởng lẫn nhau ở mức rất cao giữa các quốc gia đang cạnh tranh địa chính trị gay gắt.
Đây là lý do tại sao những sự kiện kiểu AI Safety Summit (Bletchley Park 2023, Seoul 2024) quan trọng dù nhìn có vẻ chỉ là gặp mặt ngoại giao. Chúng xây dựng shared vocabulary và ít nhất là nền tảng để các bên nói chuyện về cùng một vấn đề. Chưa đủ để giải coordination problem, nhưng thiếu bước đó thì không có gì khác chạy được.
Vấn đề kỹ thuật bổ sung: chúng ta không có công cụ đủ tốt để đánh giá frontier model. Benchmark MMLU hay HumanEval bị saturate từ lâu. Các eval về dangerous capabilities (khả năng giúp tổng hợp vũ khí sinh học, khả năng tự nhân bản, khả năng thao túng con người) vẫn còn non, methodologically inconsistent, và dễ bị công ty tự chấm điểm cho mình. Bạn không thể regulate thứ bạn không đo được.
Kỹ thuật đang làm gì để giải bài này?
Governance không thể chờ chính sách xong rồi mới làm kỹ thuật. Một số hướng đang được đẩy mạnh:
Constitutional AI (Anthropic): Thay vì dùng human feedback thuần túy, model học từ một bộ nguyên tắc (constitution) và tự đánh giá output của mình. Giảm dependency vào việc gán nhãn thủ công ở scale lớn. Nhưng câu hỏi “ai viết constitution và ai quyết nó đúng” vẫn còn nguyên.
Scalable Oversight: Khi model đủ thông minh để con người không thể đánh giá output của nó (hãy nghĩ đến proof toán học phức tạp, hay code 10.000 dòng), cần dùng AI giúp AI đánh giá AI. Đây là hướng của debate và critiquing — một model đóng vai debater, model kia đóng vai judge. Vẫn còn nhiều open problem.
Red Teaming có cấu trúc: Thay vì để một vài nhân viên thử jailbreak ngẫu hứng, các lab lớn (OpenAI, Anthropic, Google DeepMind) đang xây pipeline red teaming có hệ thống, bao gồm cả automated red teaming dùng chính LLM để sinh attack vector. Kết quả phải có documentation để external audit.
Model Cards và System Cards: Tài liệu hóa limitations, intended use, và known failure modes của model. Đang dần trở thành tiêu chuẩn tối thiểu trước khi deploy, dù chất lượng thực tế của các document này rất khác nhau.
Không có kỹ thuật nào trong số trên là silver bullet. Thực tế, phần lớn chúng còn đang trong giai đoạn nghiên cứu tích cực, chưa có consensus về “làm đúng” trông như thế nào.
Việt Nam ở đâu trong bức tranh này?
Câu hỏi thực tế hơn cho anh em tech Việt Nam: chúng ta cần biết cái này để làm gì?
Vài điểm đáng chú ý:
Về regulatory: Việt Nam đang trong giai đoạn xây dựng khung pháp lý AI — Chiến lược Quốc gia về nghiên cứu, phát triển và ứng dụng AI đến 2030 đã có, nhưng luật cụ thể còn đang phát triển. Khoảng thời gian này là cơ hội và cũng là rủi ro — cơ hội vì chưa bị lock-in vào approach nào, rủi ro vì dễ bị cuốn theo trend mà không nghĩ đủ về trade-off.
Về thực chiến: Nếu bạn build sản phẩm AI bán sang EU hoặc xử lý data của user EU, EU AI Act ảnh hưởng đến bạn dù công ty đặt ở Việt Nam. Không khác gì GDPR năm xưa. Cần nghiên cứu ngay.
Về kỹ thuật: Red teaming, eval benchmarks, output monitoring — đây không phải “làm cho đủ compliance”. Đây là engineering tốt. Team nào build AI feature mà không có monitoring và eval loop thực sự đang bay mù.
Kết: không có bữa trưa miễn phí, và không có quy định nào hoàn hảo
Câu hỏi không phải là “có nên quản lý AI không” — câu hỏi là “quản lý thế nào, ai quản lý, và theo mục tiêu gì.”
EU AI Act có lỗ hổng. Executive Order Mỹ còn thiếu răng. Các tiêu chuẩn kỹ thuật về safety đang bắt kịp chứ chưa đủ. Coordination giữa các quốc gia còn rất sơ khai. Tất cả những điều này là thật.
Nhưng cũng thật là: so với ba năm trước, chúng ta đang ở vị trí tốt hơn đáng kể. Có nhiều người làm safety research hơn. Có nhiều disclosure hơn từ các lab. Có nhiều cuộc nói chuyện chính phủ-ngành công nghiệp hơn. Tiến độ chậm, nhưng không đứng yên.
Với người làm tech, bài học thực dụng nhất không phải là chờ policy xong rồi mới nghĩ đến safety. Mà là: build evaluation trước khi deploy, document limitation rõ ràng, và đừng tin model sẽ tự biết giới hạn của nó.
Vì model không biết. Bạn phải biết thay nó.
Found this insightful? Like or share with your team:
Spread good engineering craft & architecture lessons.
Comments
Email is not published. Keep it professional.