
Self-hosted AI trong homelab — giấc mơ tự do và cái quạt GPU rú lúc nửa đêm
Kéo model về máy nhà chạy cho riêng tư, không tốn tiền API, không sợ OpenAI đổi policy. Giấc mơ đẹp cho tới khi bạn thấy VRAM cạn đáy, quạt hú như phản lực và hóa đơn tiền điện gõ cửa.
Kịch bản này quen lắm, cá là mười ông dựng homelab thì chín ông từng trải qua.
Một tối đẹp trời, sau khi đọc xong một bài post trên Reddit hoặc xem video YouTube của các pháp sư công nghệ, bạn bỗng thấy rạo rực trong người. Bạn tự nhủ: “Tại sao mình phải cúng 20 đô mỗi tháng cho Sam Altman? Dữ liệu chat của mình đi đâu? Code công ty có bị lọt ra ngoài không? Tại sao không kéo mã nguồn mở về máy nhà tự chạy cho nó tự do, độc lập, chuẩn chất dân chơi tự chủ công nghệ?”
Thế là bạn dọn dẹp góc bàn, lục lại chiếc PC cũ hoặc lên mạng săn vội một con card đồ họa trâu cày thanh lý. Bạn gõ một dòng lệnh duy nhất để cài Ollama, pull con model 8B hoặc 14B về, và bấm gửi câu hỏi đầu tiên.
Chữ bắt đầu tuôn ra trên màn hình. Bạn ưỡn ngực, cảm giác như mình vừa biến phòng ngủ thành một trung tâm dữ liệu thu nhỏ của Google.
Nhưng sự phấn khích thường chỉ kéo dài được đến… nửa đêm.
Đó là lúc bạn thử ném cho con bot một file tài liệu 20 trang để tóm tắt. Đột nhiên quạt tản nhiệt GPU rít lên từng hồi như động cơ máy bay Boeing sắp cất cánh. Nhiệt độ phòng ngủ leo dốc thẳng đứng lên 38 độ C. Dòng chữ trên màn hình ngưng bặt, kèm theo một dòng thông báo đỏ lòm cụt lủn: CUDA out of memory.
Chào mừng bạn đến với thế giới của Self-hosted AI — nơi giấc mơ riêng tư và độc lập công nghệ phải trả lời sòng phẳng trước định luật vật lý và đồng hồ đo điện.
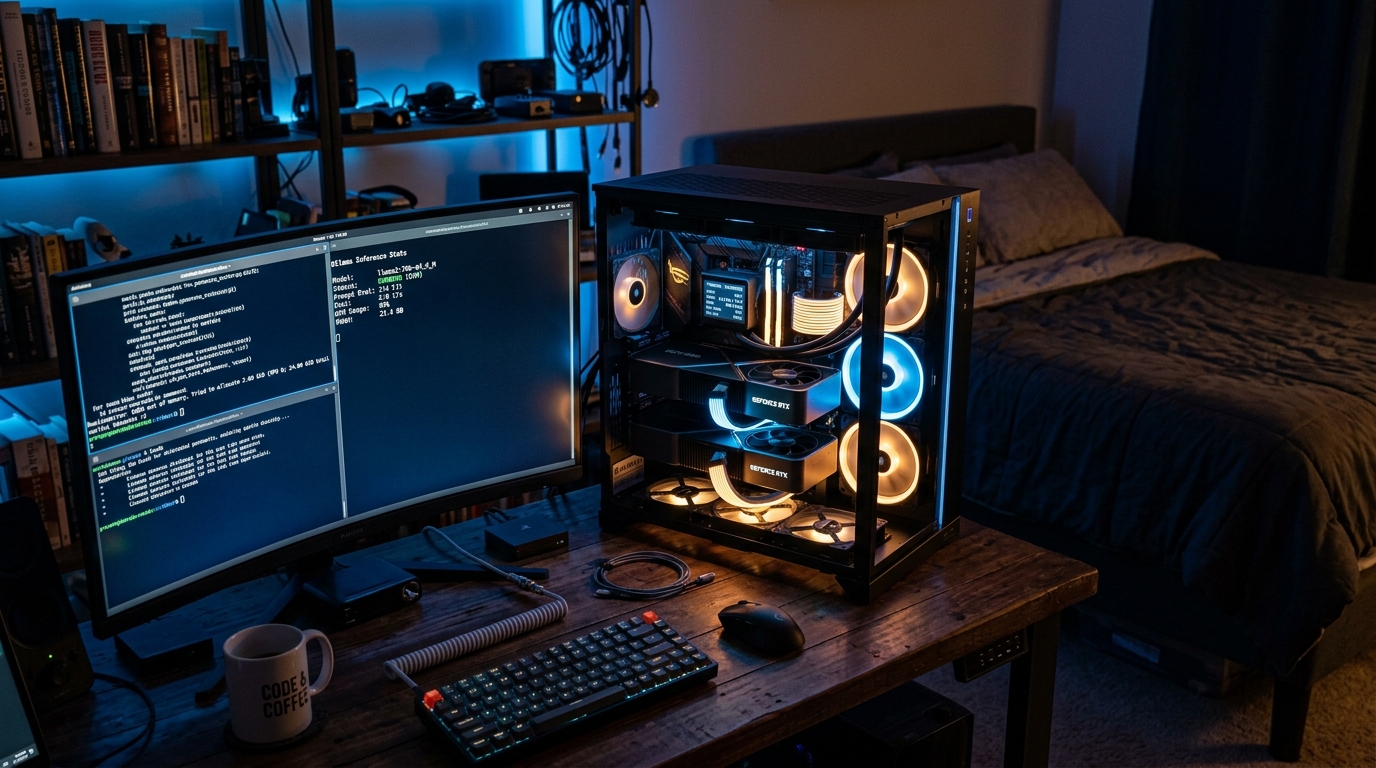
Hình 1. Giấc mơ tự chủ công nghệ lúc nửa đêm: thùng máy PC hầm hố, quạt GPU quay tít và dòng thông báo CUDA out of memory quen thuộc.
Ba động lực đẹp đẽ và ba cú tát thực tế
Dân homelab không điên. Ý định tự dựng AI ở nhà xuất phát từ những bài toán rất thật mà các dịch vụ điện toán đám mây công cộng (public cloud) không giải quyết trọn vẹn được:
- Quyền riêng tư tuyệt đối (Absolute Privacy): Bạn có những file tài liệu tài chính, nhật ký cá nhân, hoặc code dự án có thỏa thuận bảo mật (NDA) nghiêm ngặt. Ném những thứ đó lên máy chủ của bên thứ ba luôn đi kèm cảm giác bất an.
- Không bị “kiểm duyệt” hay đổi luật chơi (Zero Guardrails & Stability): Một sáng thức dậy, model cloud bạn vẫn dùng bỗng dưng từ chối trả lời vì dính một từ khóa nhạy cảm mới trong chính sách an toàn, hoặc API tăng giá gấp đôi. Ở nhà bạn, model thuộc quyền sở hữu của bạn.
- Chơi vì đam mê (The Tinkerer’s Joy): Cảm giác tự tay cấu hình Linux, tối ưu từng kernel CUDA, tinh chỉnh mạng LAN 2.5GbE và nhìn hệ thống vận hành trơn tru là một thứ gây nghiện khó bỏ của dân kỹ thuật.
Nhưng từ đam mê đến một hệ thống dùng được hàng ngày là một khoảng cách mênh mông, bị chặn lại bởi 3 bức tường vật lý.
Nút thắt #1: VRAM là vua, RAM hệ thống là dối trá có bus còi
Khi mới bước chân vào bộ môn này, sai lầm phổ biến nhất của anh em là nhìn vào RAM của máy tính.
Nhiều bạn hào hứng: “Máy mình cắm hẳn 64GB hay 128GB RAM DDR5, lo gì không chạy được model Llama-3-70B hay Qwen-2.5-72B bản lượng tử hóa (quantized)?”
Sau đó, bạn dùng các công cụ như llama.cpp để “offload” một phần model lên RAM máy tính thông qua CPU. Và kết quả là bạn được trải nghiệm cảm giác quay về thời kỳ modem quay số dial-up năm 2000: tốc độ sinh từ 1.2 token mỗi giây. Bạn hỏi một câu, đi pha gói mì tôm, ăn xong quay lại thấy nó mới gõ được nửa đoạn văn.
Tại sao lại có bi kịch này?
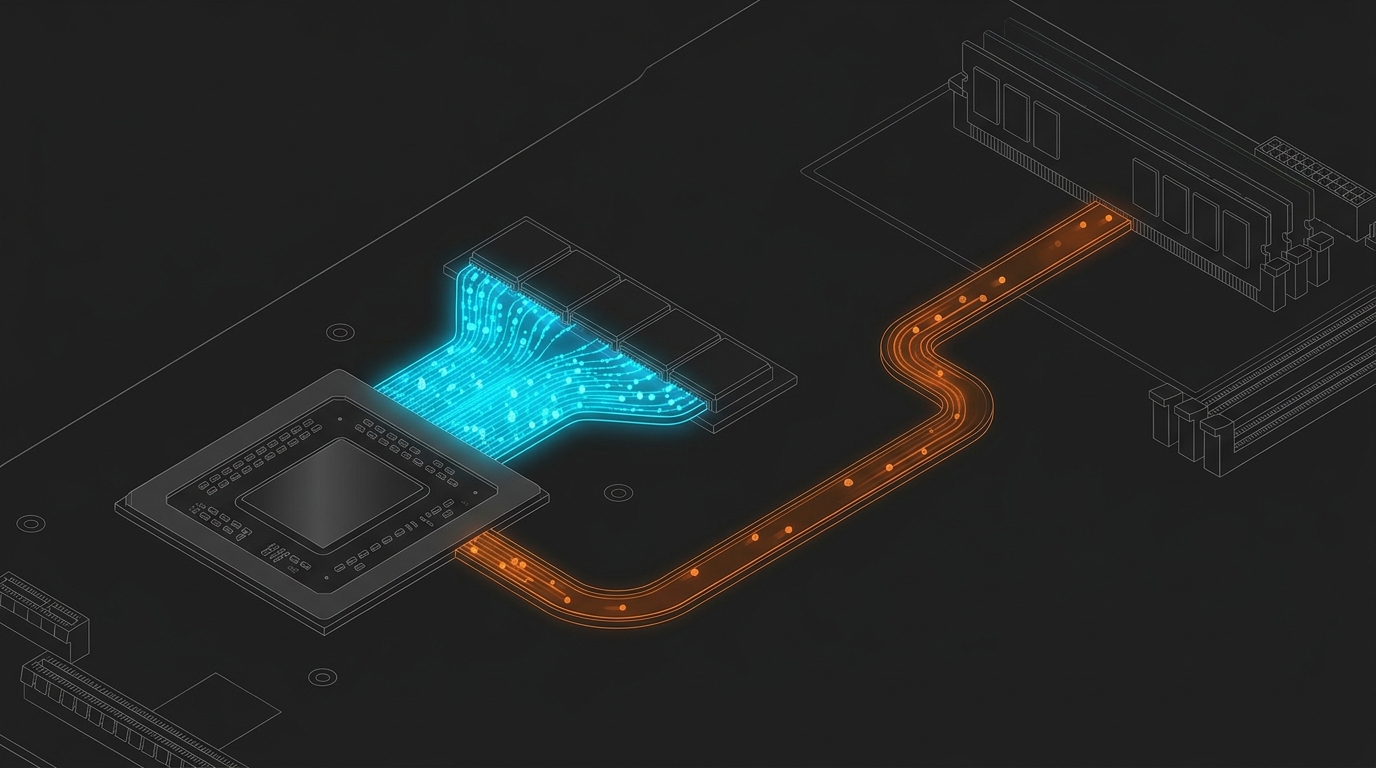
Hình 2. Trái: Băng thông khổng lồ (>900 GB/s) kết nối trực tiếp nhân GPU với VRAM. Phải: Nút thắt cổ chai hẹp qua khe cắm PCIe đưa dữ liệu về RAM hệ thống khiến tốc độ suy luận tụt dốc không phanh.
Bí mật nằm ở Băng thông bộ nhớ (Memory Bandwidth), chứ không phải độ lớn dung lượng:
- Để sinh ra đúng 1 token tiếp theo trong quá trình suy luận (autoregressive generation), mô hình buộc phải đọc qua toàn bộ trọng số (weights) của nó một lần từ bộ nhớ vào các nhân tính toán.
- Một model nặng 14GB nghĩa là mỗi token sinh ra, phần cứng phải luân chuyển đúng 14GB dữ liệu qua lại giữa chip và RAM.
- Card đồ họa như RTX 3090 / 4090 sở hữu bộ nhớ VRAM GDDR6X với băng thông lên tới 936 đến 1.008 GB/s. Nhờ vậy, nó có thể nhai gọn và trả ra 40–60 tokens/giây mượt mà như người thật đang gõ phím.
- Trong khi đó, cặp RAM DDR5 kép cắm trên mainboard chỉ cho băng thông thực tế quanh quẩn 60–80 GB/s. Chưa kể, dữ liệu còn phải xếp hàng chui qua khe cắm PCIe.
Quy tắc vàng của inference: Model nào không nằm trọn 100% trong VRAM của GPU, model đó không dành cho trải nghiệm tương tác thời gian thực (real-time chat).
Chưa hết, còn một kẻ cắp VRAM thầm lặng mang tên KV Cache.
Khi bạn chỉ chat qua lại 1–2 câu, bộ nhớ đệm ngữ cảnh (KV Cache) chỉ chiếm vài trăm megabyte. Nhưng nếu bạn nhét vào đó một bài viết 20.000 từ (khoảng 30k context) để con bot phân tích, riêng phần lưu trữ trạng thái attention của các token cũ có thể nuốt trọn từ 4GB đến 8GB VRAM. Con GPU 16GB của bạn vốn vừa đủ tải trọng số mô hình lúc khởi động, nay lập tức sụp đổ vì tràn bộ nhớ.
Nút thắt #2: Hóa đơn tiền điện và bài toán TCO
Lúc ngồi tính tiền trên giấy, dân homelab rất hay làm phép tính ngây thơ:
Tiết kiệm giả định = 20 USD/tháng × 12 tháng = 240 USD/năm
Nhưng hãy ngồi lại quán trà đá và bấm máy tính thực tế theo chi phí sở hữu toàn diện (TCO - Total Cost of Ownership):
| Hạng mục chi phí | Phương án dùng Cloud API (OpenAI / Claude / OpenRouter) | Dàn Homelab tự dựng (RTX 3090 24GB cũ) |
|---|---|---|
| Chi phí đầu tư ban đầu (Capex) | 0 VNĐ (dùng máy tính sẵn có) | 22.000.000 – 35.000.000 VNĐ (Card, nguồn 1000W, tản nhiệt, case thoáng) |
| Tiền điện hàng tháng (Opex) | 0 VNĐ | 300.000 – 600.000 VNĐ/tháng (chạy idle 40W, tải 350W, tính giá điện bậc thang) |
| Chất lượng mô hình (Intelligence) | SOTA (Claude 3.7 Sonnet, GPT-4.5, Gemini 2.5 Pro) | Open-weights cỡ vừa (Qwen-2.5-32B, Llama-3.3-8B) |
| Độ tin cậy & Bảo trì | 99.9% SLA, không cần đụng tay | Tự sửa lỗi driver CUDA, tự cập nhật weights, lo tản nhiệt phòng |
Một chiếc card đồ họa khủng khi chạy hết công suất sẽ ăn khoảng 350W đến 420W. Cộng thêm CPU, quạt và mainboard, cỗ máy của bạn là một chiếc lò sưởi mini 500W. Vào mùa hè Việt Nam, nếu bạn để máy trong phòng ngủ, điều hòa của bạn sẽ phải gồng mình chạy thêm để triệt tiêu nhiệt lượng đó — nhân đôi lượng điện tiêu thụ một cách vô hình.
Nếu nhu cầu thực tế của bạn chỉ là gõ vài chục prompt mỗi ngày để hỏi đáp lập trình hoặc dịch thuật, số tiền 25 triệu sắm dàn trâu cày đủ để bạn nạp tiền gọi API trên OpenRouter trong suốt… 4 đến 5 năm với chất lượng model thông minh vượt trội.
Kiến trúc Homelab AI thực chiến: Dựng thế nào cho chuẩn bài?
Nếu sau khi biết rõ các rào cản trên, bạn vẫn quyết tâm dựng vì bài toán bảo mật dữ liệu hoặc phục vụ hệ thống tự động hóa gia đình, thì đâu là kiến trúc chuẩn chỉ, không chắp vá?
Một hệ thống self-hosted AI tử tế trong homelab năm 2026 nên được phân lớp như sơ đồ dưới đây:
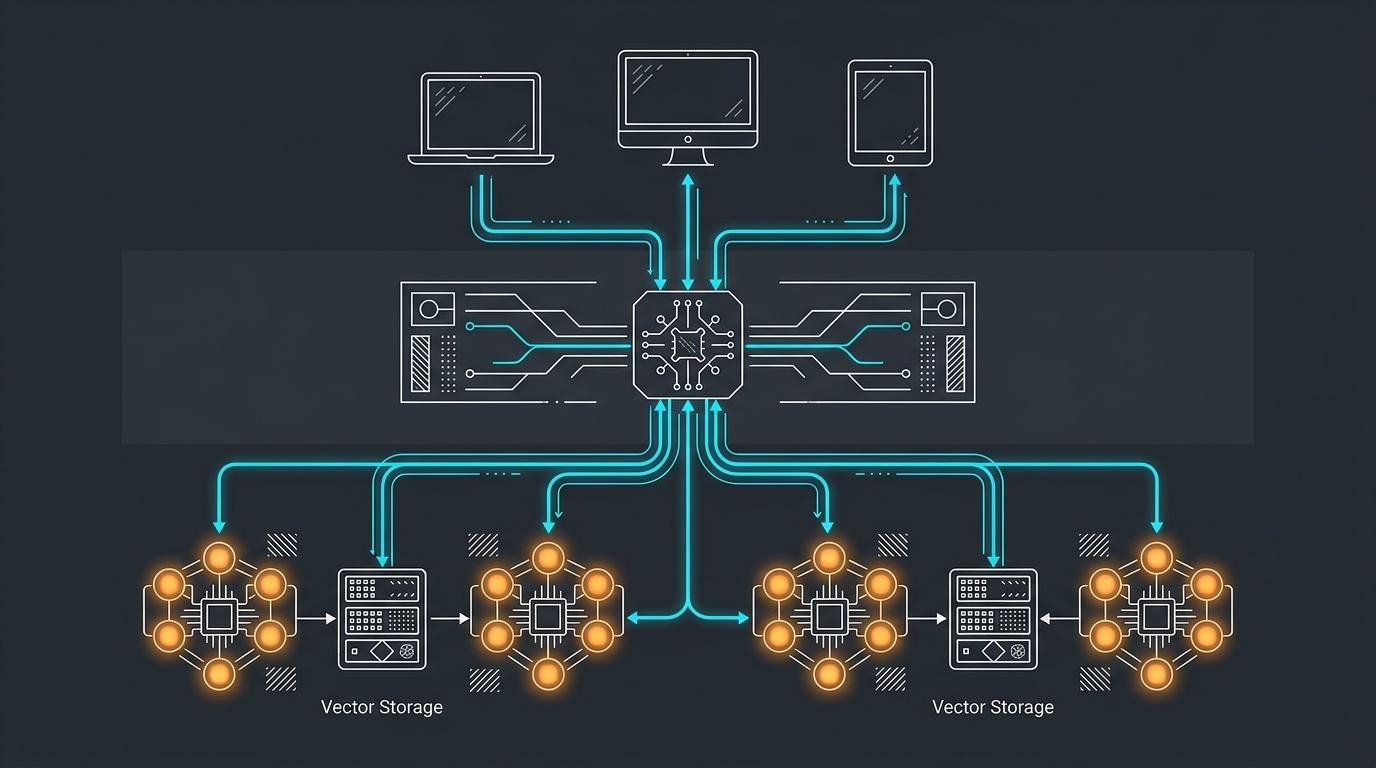
Hình 3. Kiến trúc 3 tầng chuẩn mực: Khách hàng (Clients) → Trạm trung chuyển API Gateway (LiteLLM) → Động cơ tính toán chuyên dụng (Inference Engines).
1. Tầng Giao diện (Client Apps)
Đừng bắt người thân trong nhà mở terminal để gõ lệnh. Bạn cần các ứng dụng đầu cuối thân thiện:
- Open WebUI: Giao diện web đẹp không kém gì ChatGPT, hỗ trợ phân quyền người dùng, upload tài liệu làm RAG cục bộ và tạo chatbot riêng cho gia đình.
- IDE Extensions (Continue.dev / Cline / Roo Code): Cắm trực tiếp vào VS Code hoặc Cursor để làm trợ lý viết code nội bộ, quét toàn bộ repo công ty mà không lo vi phạm chính sách bảo mật.
- Home Assistant: Kết nối model nhỏ cục bộ với hệ thống nhà thông minh để điều khiển đèn, quạt, máy lạnh bằng giọng nói tự nhiên thông qua Whisper (STT) và Piper (TTS).
2. Tầng Gateway điều phối: Vũ khí tối thượng LiteLLM
Đây là thành phần mà 90% người mới làm homelab hay bỏ qua nhất. Thay vì trỏ thẳng client vào Ollama, hãy đặt một con LiteLLM Proxy ở giữa.
LiteLLM đóng vai trò như một anh công an giao thông thông minh:
- Fallback linh hoạt: Khi bạn hỏi những câu thông thường, nó chuyển hướng vào GPU ở nhà (miễn phí). Khi bạn yêu cầu giải toán cao cấp hay viết một bài phân tích kiến trúc phức tạp vượt quá sức của model 8B, nó sẽ tự động định tuyến sang API Claude Sonnet hoặc OpenAI trên mây.
- Quản lý hạn mức: Giới hạn token cho từng thành viên trong nhà hoặc từng ứng dụng client, tránh tình trạng một con loop agent bị lỗi cắn sạch tài nguyên suốt đêm.
3. Tầng Động cơ tính toán (Inference Engines)
Tùy vào mục đích sử dụng mà bạn chọn “động cơ” phù hợp:
- Ollama: Lựa chọn số 1 cho người nhập môn. Đóng gói tất cả trong một, quản lý model như Docker images (
ollama pull,ollama run). Cực kỳ tiện nhưng khả năng phục vụ đồng thời nhiều người dùng (concurrent requests) ở mức cơ bản. - vLLM: Tiêu chuẩn công nghiệp nếu bạn muốn dùng homelab phục vụ nhiều agent chạy song song. Nhờ thuật toán PagedAttention quản lý bộ nhớ KV cache như phân trang trong hệ điều hành và kỹ thuật Continuous Batching, vLLM vắt kiệt từng giọt hiệu năng của GPU.
- llama.cpp: Lựa chọn kinh điển bằng C/C++ thuần cho những ai thích đào sâu, tối ưu hóa tới từng byte trên các thiết bị tài nguyên hạn chế.
Ba nấc thang phần cứng: Liệu cơm gắp mắm
Nếu chuẩn bị rút hầu bao, đây là 3 cấu hình thực tế nhất cho homelab hiện nay:
Nấc 1: “Nhà nghèo vượt khó” — Mini PC chip N100 hoặc PC văn phòng cũ (3 – 6 triệu VNĐ)
- Khả năng: Chạy hoàn toàn bằng CPU.
- Mục tiêu: Đừng mơ chạy model ngôn ngữ lớn để chat. Hãy dùng nó để chạy các model siêu nhỏ: mô hình nhúng văn bản (bge-m3 / nomic-embed-text) để làm tìm kiếm ngữ nghĩa, Whisper bản tiny để nhận diện giọng nói cho smart home, hoặc các model 1B–3B siêu nhẹ để phân loại email, lọc spam.
Nấc 2: “Quốc dân thực dụng” — PC đồ họa cắm RTX 3060 12GB hoặc RTX 3090 24GB cũ (15 – 30 triệu VNĐ)
- Khả năng:
- RTX 3060 12GB: Chạy cực mượt các model kích thước 8B ở định dạng quantize 4-bit (Q4_K_M) hoặc 8-bit. Đủ cho nhu cầu chat hàng ngày và làm trợ lý code cá nhân.
- RTX 3090 24GB: “Bảo vật quốc gia” của dân chơi AI homelab. Với 24GB VRAM và băng thông gần 1TB/s, bạn có thể chạy thoải mái các dòng model 14B đến 32B (như Qwen-2.5-32B-Instruct Q4) — ngưỡng kích thước bắt đầu cho ra câu trả lời thực sự sắc sảo và thông minh.
Nấc 3: “Dân chơi hệ êm ái” — Mac Mini / Mac Studio Apple Silicon (M2/M3/M4)
- Khả năng: Kiến trúc Bộ nhớ hợp nhất (Unified Memory) của Apple là một “cheat code” trong làng AI. CPU, GPU và Neural Engine dùng chung một hồ RAM với băng thông từ 150 GB/s (bản Pro) đến 800 GB/s (bản Ultra).
- Một chiếc Mac Studio 64GB hoặc 128GB RAM có thể nhét trọn các model khổng lồ 70B mà cỗ máy chỉ tiêu thụ chưa đầy 80W điện, mát rượi và êm ái tuyệt đối trong đêm. Nhược điểm duy nhất: giá thành của Apple chưa bao giờ biết đến hai chữ “bình dân”.
Lời kết từ bàn trà đá: Khi nào nên bấm nút mua?
Trước khi bạn mở tab thương mại điện tử để đặt mua card đồ họa, hãy tự trả lời sòng phẳng 3 câu hỏi này:
- Bạn có dữ liệu nhạy cảm không được phép rời khỏi mạng nội bộ không? Nếu có → Tự host là bắt buộc, không cần bàn cãi thêm.
- Bạn đang muốn học hỏi về hạ tầng, DevOps, mạng máy tính và cơ chế suy luận LLM? Nếu có → Hãy dựng ngay. Kiến thức bạn thu được từ việc tự tay cấu hình CUDA, tối ưu VRAM và gỡ lỗi mạng nội bộ đáng giá gấp nhiều lần số tiền bạn bỏ ra.
- Bạn chỉ đơn thuần muốn một trợ lý ảo thông minh nhất để làm việc năng suất hơn mỗi ngày? Nếu câu trả lời là đúng → Dừng lại ngay. Hãy tiếp tục dùng Claude, ChatGPT hoặc bỏ 10 đô nạp API. Model cục bộ cỡ 8B hay 14B không thể đọ lại khả năng lập luận, viết code và chiều sâu kiến thức của các siêu mô hình trên mây.
Tự dựng AI trong homelab cũng giống như việc bạn tự rang xay cà phê thủ công tại nhà vậy. Nó tốn công hơn, tốn tiền mua máy hơn, đôi khi pha ra một ly chua loét khó uống. Nhưng cái cảm giác tự tay làm chủ toàn bộ quy trình, không phụ thuộc vào bất kỳ ai — đó mới là giá trị đích thực khiến anh em công nghệ không bao giờ chịu ngồi yên.
Found this insightful? Like or share with your team:
Spread good engineering craft & architecture lessons.
Comments
Email is not published. Keep it professional.